主题 快速了解系列
创建 2026年9月18日 / 更新 2026年9月18日
浏览 — / 评论 — / 字数 3,022
 Content · 前沿AI资讯
一篇面向开发者的 Jev 入门指南:介绍它与传统生成式 LLM 的差异、请求体结构、Choice、Score 与 Noul 三种问题类型、当前调用渠道及实用的决策设计最佳实践。
Jev 是 TypeSafe 推出的首个 System One 模型,专为软件中的快速、结构化决策而设计。它接收文本状态(state)和类型化问题(typed questions),直接返回带概率的是非判断,以及带概率分布和置信度的候选选择或评分结果,不生成自然语言,也无需再把文本解析成程序可用的数据。
这里的 System One 是 TypeSafe 对这类评估模型的产品分类名称,不应直接等同于认知科学中的“系统一”。
所以可以将 Jev 理解为一种面向“判断”而非“生成”的语言模型接口。
如果你的程序需要完成分类、评分、意图识别或风险判断,而不是生成一段文字,Jev 就可能比传统生成式 LLM 更接近你真正需要的接口。
传统生成式 LLM 的典型形式是:
messages / prompt
→ 自回归生成 token
→ 文本或 JSON
→ 再解析成程序需要的结果
而 Jev 的核心形式更接近:
state + typed questions
→ 直接评估有限的 decision space
→ 返回概率化、类型化的决策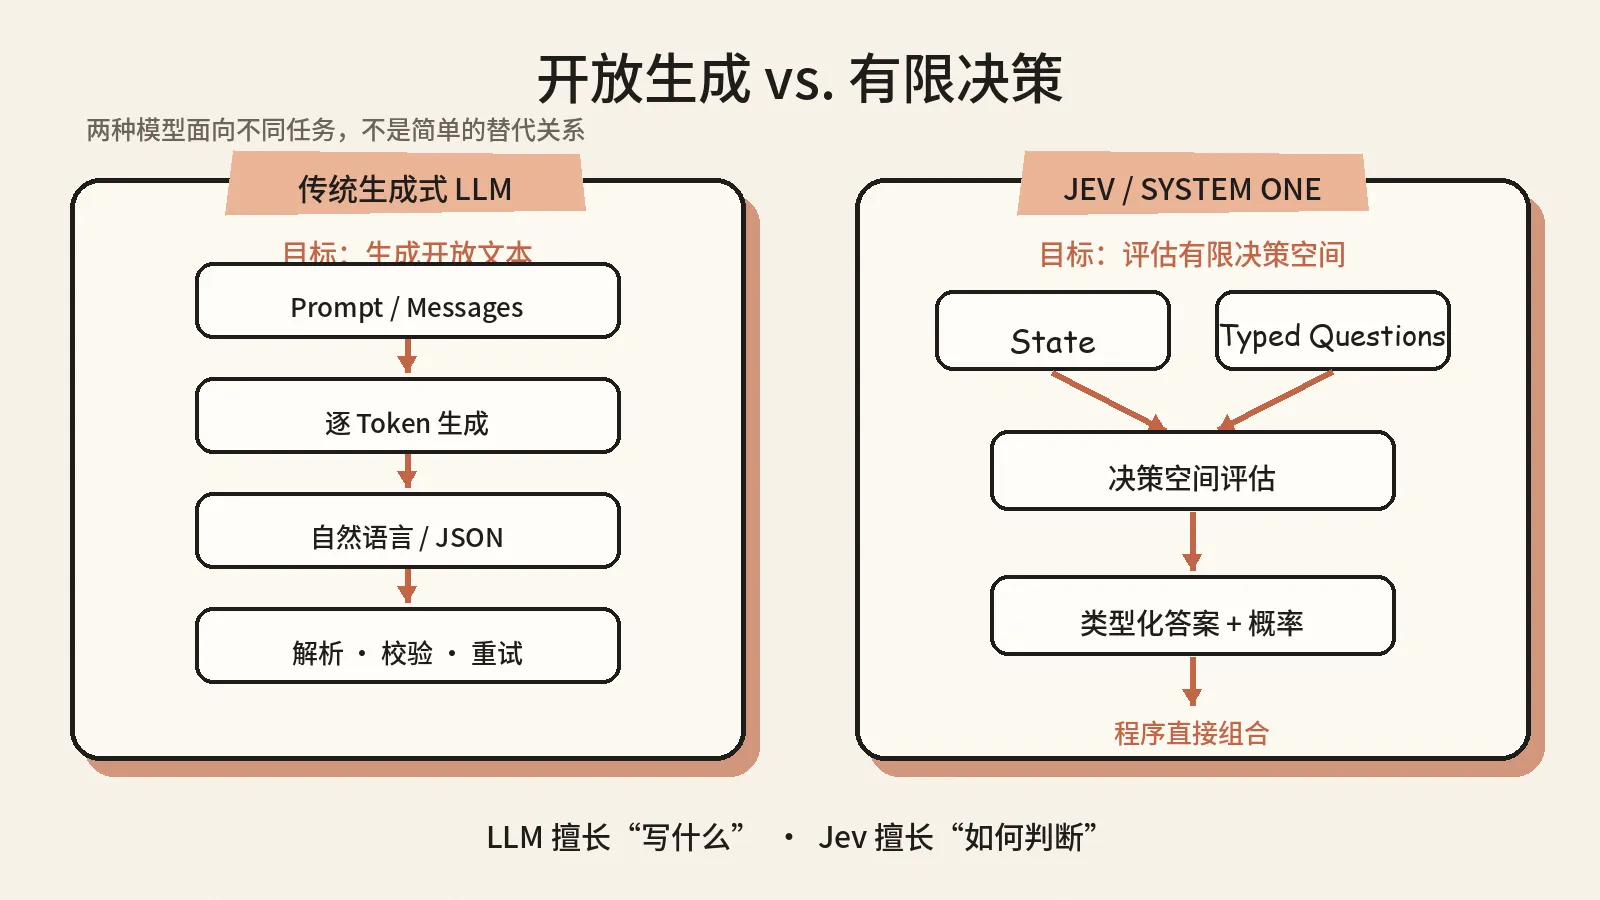
不论使用哪个渠道,核心请求结构都基本相同:
model:要使用的 Evaluation Model。TypeSafe 官方 SDK 可省略。
state:需要模型判断的材料,可以是字符串、JSON 对象或数组。
questions:需要模型完成的判断集合。
问题 ID:例如 category、urgency,返回结果会沿用这些键。
instructions:说明具体要判断什么。
criteria:定义候选选项、评分等级或真假边界。
state 类似传统 Prompt 中的上下文,但不负责定义任务;“要判断什么”由 questions 描述。一次请求可以包含多个问题,这些问题共享同一份 state,并被独立评估。
下面是使用 Vercel AI SDK 时,一个同时包含三种问题类型的完整请求体:
const result = await evaluate({
  model: "typesafe-ai/jev",

  state: {
    message: "我的信用卡被重复扣款,请尽快退款。",
    customerLevel: "premium",
  },

  questions: {
    category: {
      type: "choice",
      instructions: "这条消息属于哪类问题?",
      criteria: {
        billing: "扣款、账单或退款",
        technical: "产品故障或技术问题",
        other: "其他问题",
      },
    },

    urgency: {
      type: "score",
      instructions: "这条消息有多紧急?",
      criteria: ["不紧急", "需要优先处理", "需要立即处理"],
    },

    requestsRefund: {
      type: "boolean",
      instructions: "用户是否明确要求退款?",
      criteria: {
        true: "明确要求退回款项",
        false: "没有提出退款要求",
      },
    },
  },
});其中,category、urgency 和 requestsRefund 都是自定义的问题 ID。结果会分别出现在 result.answers.category、result.answers.urgency 和 result.answers.requestsRefund 中。
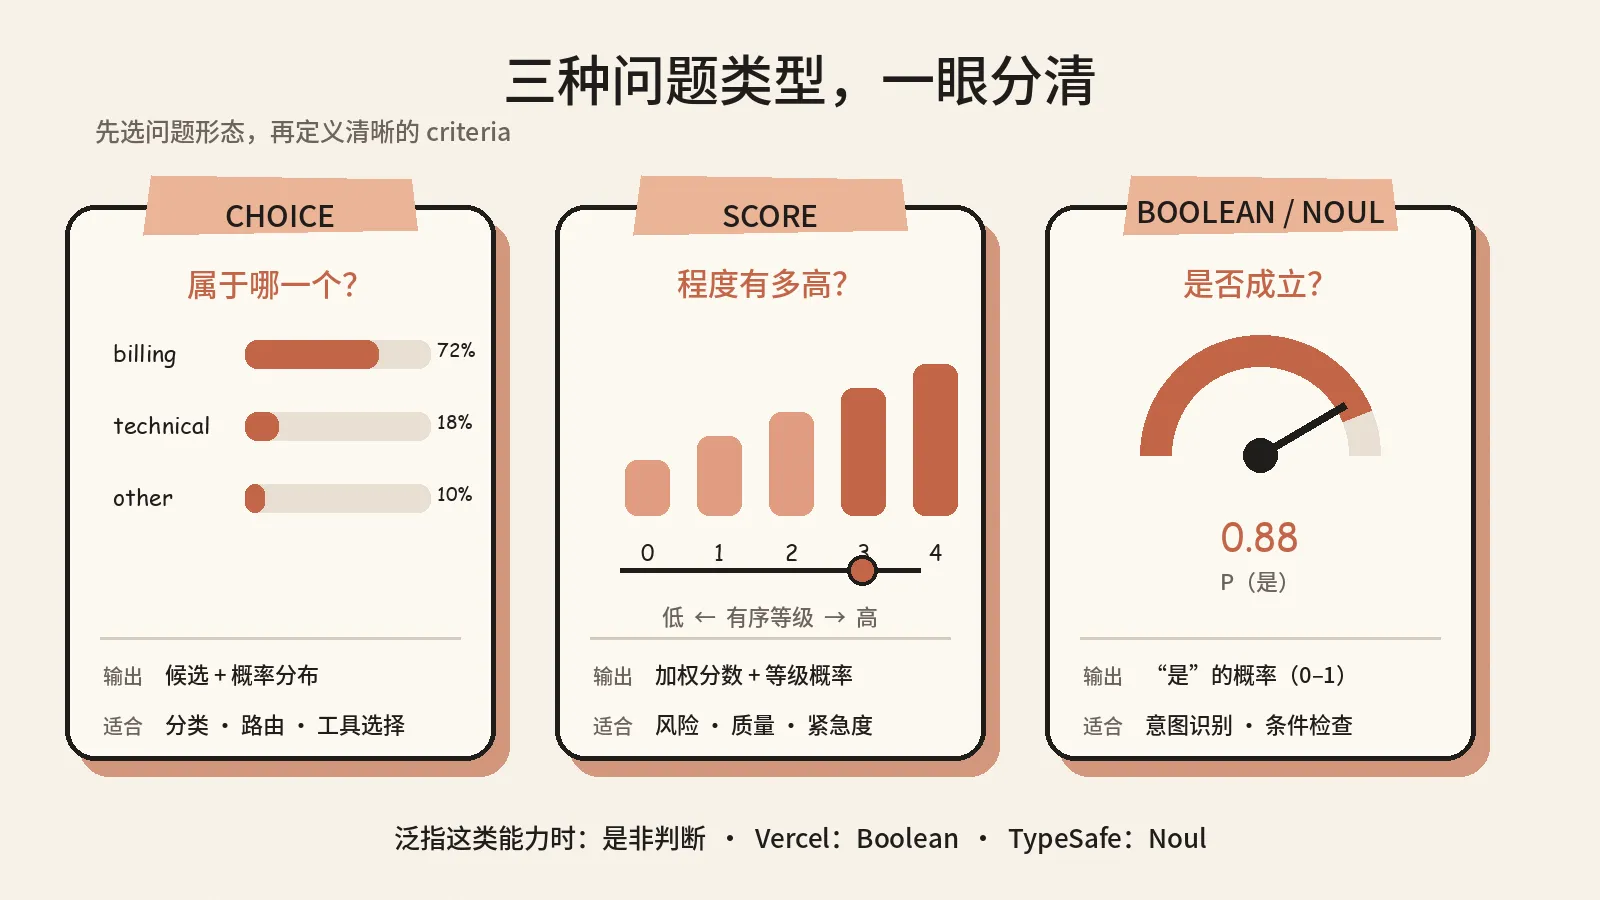
以下数值仅用于展示返回体结构。
Vercel AI SDK:
// 请求
{
  type: "choice",
  instructions: "这条消息属于哪类问题?",
  criteria: {
    billing: "账单问题",
    technical: "技术问题",
    other: "其他问题",
  },
}

// 返回:result.answers.category
{
  type: "choice",
  choice: "billing",
  probabilities: {
    billing: 0.95,
    technical: 0.02,
    other: 0.03,
  },
}

// TypeSafe 特有的置信度
result.providerMetadata.typesafe.confidence.category // 0.91
TypeSafe 官方 SDK / HTTP API:
// 请求
choice("这条消息属于哪类问题?", {
  billing: "账单问题",
  technical: "技术问题",
  other: "其他问题",
})

// 返回:response.answers.category
{
  type: "choice",
  choice: "billing",
  probabilities: {
    billing: 0.95,
    technical: 0.02,
    other: 0.03,
  },
  confidence: 0.91,
}
Choice 适合分类、路由和工具选择。候选名称应稳定且互相区分,说明文字负责界定各候选的边界。按当前文档,一个 Choice 最多支持 255 个候选,可以直接给出完整列表,不用预先筛短。
Vercel AI SDK:
// 请求
{
  type: "score",
  instructions: "这条消息有多紧急?",
  criteria: ["不紧急", "优先处理", "立即处理"],
}

// 返回:result.answers.urgency
{
  type: "score",
  score: 1.72,
  probabilities: {
    "0": 0.03,
    "1": 0.22,
    "2": 0.75,
  },
}

// TypeSafe 特有的置信度
result.providerMetadata.typesafe.confidence.urgency // 0.82
TypeSafe 官方 SDK / HTTP API:
// 请求
score("这条消息有多紧急?", [
  "不紧急",
  "优先处理",
  "立即处理",
])

// 返回:response.answers.urgency
{
  type: "score",
  score: 1.72,
  legend: {
    "0": "不紧急",
    "1": "优先处理",
    "2": "立即处理",
  },
  probabilities: {
    "0": 0.03,
    "1": 0.22,
    "2": 0.75,
  },
  confidence: 0.82,
}
Score 适合质量、风险、紧急度和完成度等程度判断。等级必须从低到高排列,返回值是各等级概率的加权结果,因此可能是小数。三档量表的范围是 0~2。量表最少需要 2 级、最多支持 10 级,能清楚地区分几级就定义几级。
Vercel AI SDK:
// 请求
{
  type: "boolean",
  instructions: "用户是否明确要求退款?",
}

// 返回:result.answers.requestsRefund
{
  type: "boolean",
  probability: 0.98,
}
TypeSafe 官方 SDK / HTTP API:
// 请求
noul("用户是否明确要求退款?")

// 返回:response.answers.requestsRefund
{
  type: "noul",
  noul: 0.98,
}
Vercel 将这种问题称为 Boolean,TypeSafe 原生接口称为 Noul。probability 或 noul 表示答案为“是”的概率,因此不会另外返回 confidence。
截至本文更新时,公开可用的主要接入渠道来自 TypeSafe AI 与 Vercel。
| 公司 / 平台 | 提供的调用方式 | 主要入口 |
| TypeSafe AI | 官方 JavaScript / TypeScript SDK | TypeSafeClient().systemOne() |
| TypeSafe AI | 官方 Python SDK | TypeSafeClient().system_one()(typesafe_sdk 包) |
| TypeSafe AI | HTTP API,可由任意语言调用 | POST /v1/systemone |
| Vercel | AI Gateway,通过 Vercel AI SDK 调用 Jev | experimental_evaluate() • typesafe-ai/jev |
| Vercel AI SDK → TypeSafe | TypeSafe Provider 适配器,使用 AI SDK 接口直接连接 TypeSafe | typeSafeAi.evaluationModel("jev-latest") |
简单来说:
TypeSafe AI 是 Jev 的开发商和原始 API 提供方。 可以使用官方 SDK,也可以直接发送 HTTP 请求。
Vercel 是第三方模型渠道。 Jev 已接入 AI Gateway,可以和其他 AI 模型一样通过 Vercel AI SDK 调用。
@ai-sdk/typesafe-ai 并不是另一家模型平台,而是 Vercel AI SDK 为 TypeSafe 提供的适配器。
两套接入方式读取的 API Key 环境变量名不同:官方 SDK 读取 TYPESAFE_API_KEY,@ai-sdk/typesafe-ai 适配器读取 TYPESAFE_AI_API_KEY,配置时注意不要混淆。
本文主要使用 Vercel AI SDK 的请求结构来说明;它与 TypeSafe 原生接口的核心概念相同,只是名称上把原生的 Noul 写成了更常见的 Boolean。
Vercel AI SDK:
result.answers.category.choice;
result.answers.urgency.score;
result.answers.requestsRefund.probability;
TypeSafe 官方 SDK:
response.answers.category.choice;
response.answers.urgency.score;
response.answers.requestsRefund.noul;
Choice 和 Score 还会提供各候选或等级的概率分布。TypeSafe 原生结果会提供相应的置信度信息;通过 Vercel 调用时,部分 TypeSafe 专属数据会放在 Provider Metadata 中。
需要注意的是,在 AI SDK 的规范中 probabilities 是可选字段:Jev 当前会返回完整的概率分布;若同一套代码还要兼容其他 provider 的 Evaluation Model,读取前仍应先判空。
Jev 更适合作为程序中的决策原语,而不是一个接收复杂目标后直接给出最终结论的全能 Agent。
比较可靠的用法是:把复杂判断拆成多个可检查的局部问题,让 Jev 提供信号,再由代码组合、设阈值并执行动作。
日期计算、金额比较、权限校验、状态机跳转等确定性规则,应该继续写在代码里。Jev 只处理需要理解自然语言、模糊语义或常识判断的部分。
// 确定性规则:直接用代码
if (invoice.daysOverdue > 30) {
  routeToCollections();
}

// 模糊判断:交给 Jev
// “客户的措辞是否表现出强烈不满?”
最终控制流、副作用和安全边界仍由程序掌握,而不是让模型自行决定整个工作流。
一个好的 question 应该像“掌握上下文的专家几秒钟就能完成的一次判断”。如果问题需要同时权衡多个独立因素、进行长链推理,或者答案很难解释为什么得出,就应该继续拆分。
不推荐:
“这张工单应该如何处理?”

更合适:
- 它属于哪个业务类别?
- 用户是否明确要求退款?
- 问题是否会阻塞核心功能?
- 是否已经提供复现步骤?
- 用户情绪有多激烈?
这不只是提示词优化。拆分后,每个判断都能单独测试、观察概率分布、调整标准,也能知道最终决策究竟受哪个维度影响。
criteriaChoice:候选应尽量互相区分;如果候选无法覆盖所有输入,加入 other 或 none_of_the_above,不要强迫模型在错误选项中挑一个。
Score:等级要描述可观察的状态,而不是只写“低、中、高”或“1~5 分”。每一档应说明区别在哪里。
是非判断:面向 Vercel AI SDK 时使用 Boolean,面向 TypeSafe 原生接口时使用 Noul;当真假边界可能有歧义时,同时定义 true 和 false,必要时加入正反例。
criteria: {
  true: "用户明确要求退回已经支付的款项",
  false: "用户只是在询问价格、账单内容或支付状态",
}
如果需要在一个庞大的树状分类体系中选择,不要把所有叶子类别塞进一次复杂判断。可以先选择顶层类别,再在该类别的直接子节点中继续选择;这类分层分类更容易控制,也便于使用 greedy 或 beam search 保留多个候选路径。
不要把整个会话、数据库记录或项目资料无差别塞进 state。应只传当前 questions 真正需要的字段,并使用有名称的 JSON 结构保持关系明确。
state: {
  ticket: {
    message: ticket.message,
    status: ticket.status,
  },
  order: {
    paymentStatus: order.paymentStatus,
    deliveryStatus: order.deliveryStatus,
  },
  refundPolicy: currentRefundPolicy,
}
问题中应明确指出要检查哪个字段,例如“根据 ticket.message 判断用户是否要求退款”。相关上下文越清晰,模型越不容易被无关信息干扰。
不要直接让 Jev 回答“这个候选人是否值得录用”或“这张工单的优先级是多少”。先把结论拆成相互独立的维度,再分别使用 Score、Choice 或是非判断。
例如,工单优先级可以拆成:
severity:问题本身有多严重;
customerImpact:影响了多少用户或业务;
reportQuality:现有信息是否足以开始处理;
frustration:用户情绪是否正在升级。
不同 Score 的量表长度可能不同,因此组合前应先归一化到 0~1,再由代码明确设置权重:
const normalized = (score: number, levelCount: number) =>
  score / (levelCount - 1);

const severity = normalized(answers.severity.score, 3);
const impact = normalized(answers.customerImpact.score, 4);
const quality = normalized(answers.reportQuality.score, 4);

const priority = 0.5 * severity + 0.35 * impact + 0.15 * quality;
这样做比让模型直接输出一个“综合分”更可控:权重可以版本化、审计和调整,各维度也能单独排查。如果固定加权仍然不够,还可以把各项概率作为特征,交给下游的传统分类器或回归模型学习组合方式。
同一份 state 上的 questions 会独立、并行评估。因此,与其先问类别、等待结果,再决定是否询问风险和退款,不如把可能需要的独立问题一起发送,之后由代码决定哪些答案需要使用。
这种方式适合:
工单分流时同时判断类别、紧急度、退款意图和信息完整度;
Agent 执行后同时验证工具选择、参数、结果引用和安全条件;
内容审核时同时检测多种互不依赖的风险。
但如果第二个问题的内容必须依赖第一个问题的结果,就不应该伪装成并行问题,而应由代码发起下一轮调用。
Choice 的第二名概率通常不是噪音。例如 returns: 0.60、billing: 0.38 说明工单可能同时涉及退货和扣款,仅看最终 choice 会丢掉重要信息。
可以根据概率分布和 confidence 设计不同路径:
if (confidence < 0.5) {
  requestMoreInformation();
} else if (action === "read_only") {
  executeAutomatically();
} else if (action === "money_transfer" && confidence > 0.9) {
  executeAutomatically();
} else {
  askForConfirmation();
}
阈值不应全系统共用一个固定数字。低风险、可撤销的动作可以使用较低阈值;转账、删除、封禁等高风险动作应要求更高置信度,或始终需要人工确认。
confidence 表示概率分布是否集中,不代表“答案有同样百分比的概率正确”。上线前应准备带正确标签的真实案例,分别观察:
各问题的准确率和错误类型;
不同 confidence 区间对应的真实正确率;
哪些输入会让概率分布变平;
自动执行、请求补充信息和转人工的阈值应该放在哪里。
建议先使用保守阈值,再根据线上数据逐步调整。规则、权重、criteria 和阈值都应该像普通代码一样进入版本管理和评测流程。
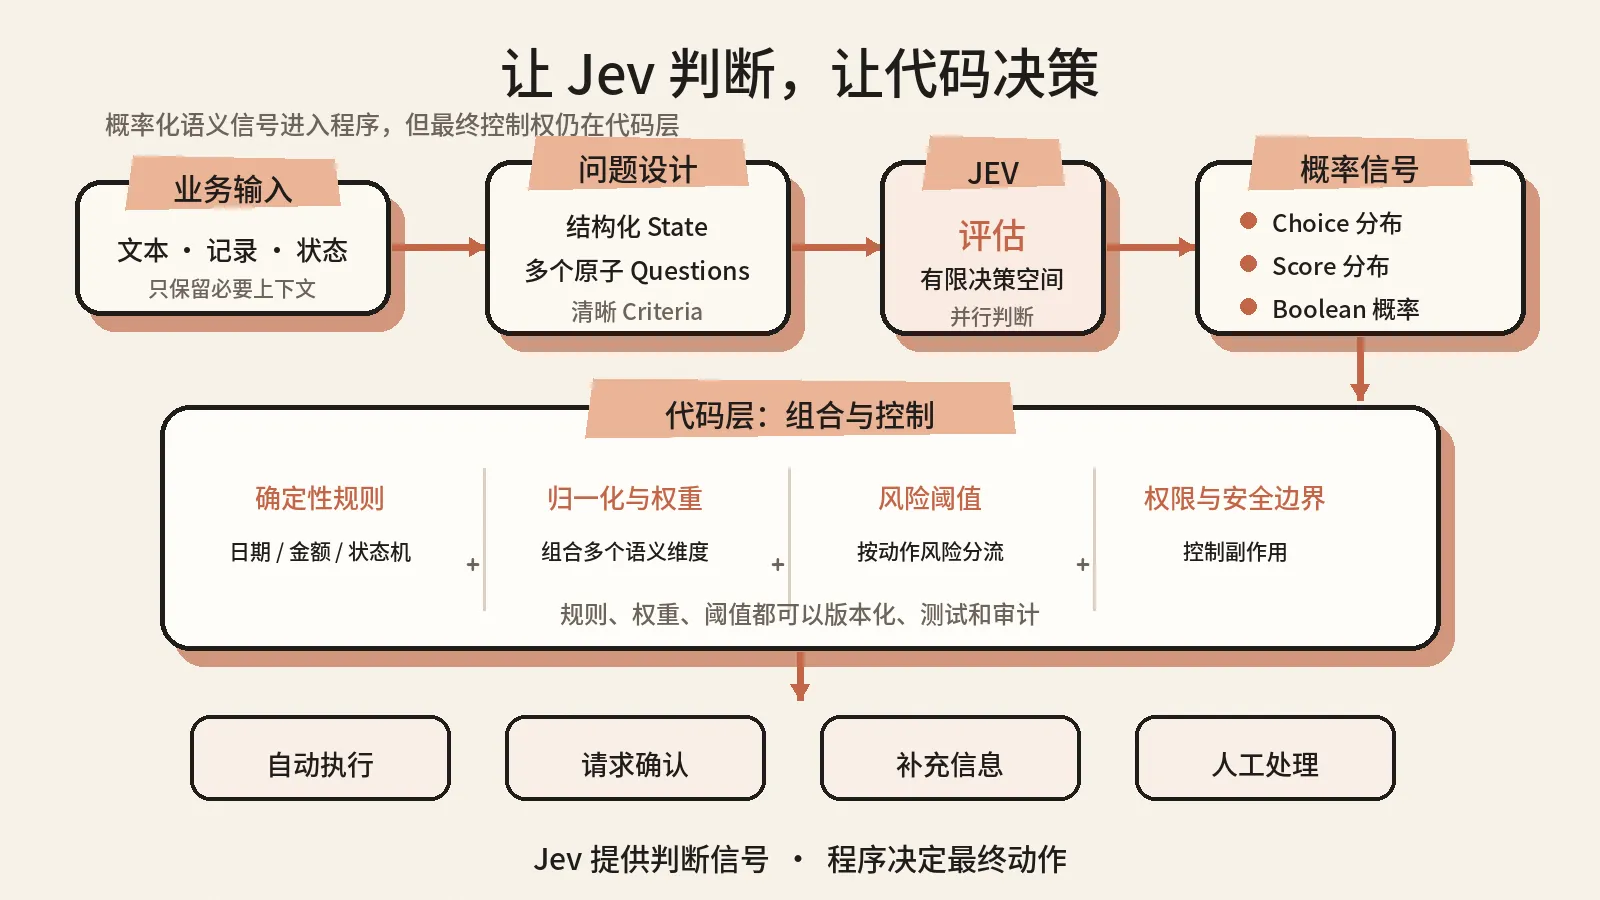
Jev 的优势不在于替代所有业务逻辑,而在于把原本难以编码的语义判断转化成可观察、可组合、可由软件控制的概率信号。
TypeSafe AI 官方资料:
Vercel 相关资料:
评论
欢迎留下笔记、问题和后续想法。
评论将在接近此区域时加载。
评论暂时不可用,因为尚未配置 WALINE_SERVER_URL or PUBLIC_WALINE_SERVER_URL。